中文
 EN


光明实验室生成式大模型团队研发的多智能体创意生成系统 Open Creative Agent 正式开源发布
![]() 发布时间:2026-07-21
![]() 作者:光明实验室
![]() 浏览:444次
近日,光明实验室生成式大模型团队自主研发的多智能体创意生成系统 Open Creative Agent 正式对外开源发布,全部代码以 Apache-2.0 协议向社会开放。
系统代码、说明文档与部署指引已在 GitHub 平台发布
仓库地址:http://github.com/GML-FMGroup/open-creative-agent
一句话到成品:二十个智能体协同完成全链路创作
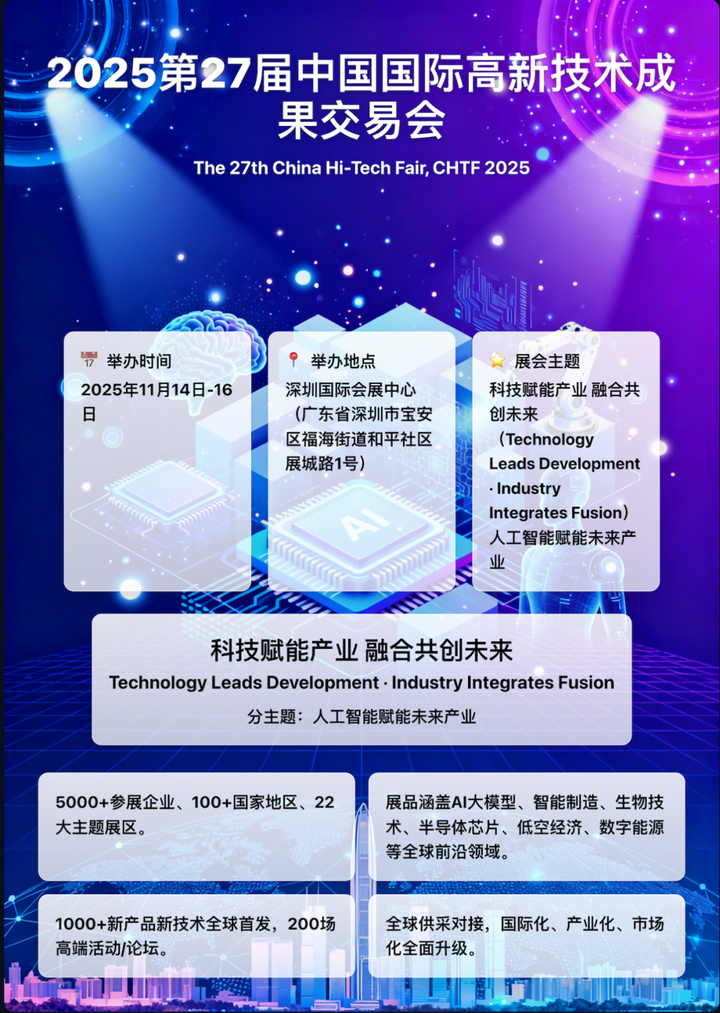
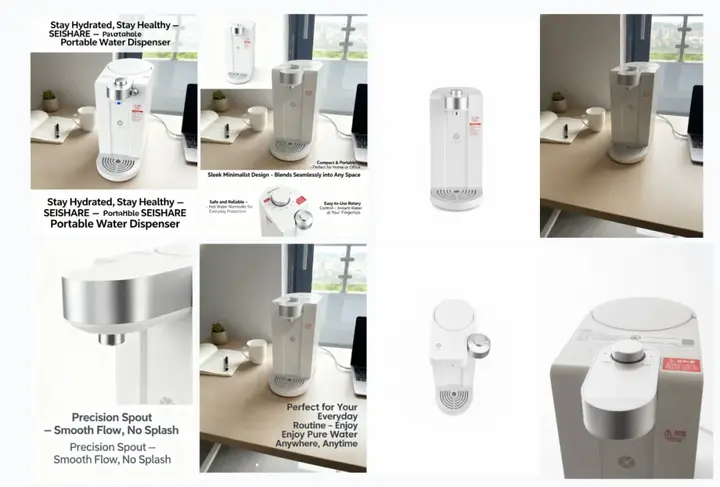
海报、电商图组、图文文章、界面设计,是宣传、电商、教育等领域最常见的视觉创作需求。以往完成这样一件作品,往往要在检索、设计、生成、排版等多个环节和工具之间辗转。Open Creative Agent 把这条链路交给二十个各有专长的智能体协同完成:用户只需用一句话说明需求——也可以附上一张图片,或一份 PDF、Word 文档作为素材——系统便自动完成资料检索、方案设计、图像生成与版面排布,最终把可以直接使用的成品交到用户手上。这一产品形态与近来广受关注的 Lovart.ai 属于同一类,可以把 Open Creative Agent 理解为 Lovart.ai 的本地部署开源版:同样是“一句话到成品”的创作体验,而系统部署运行在用户自己的电脑上,全部代码开放可改。
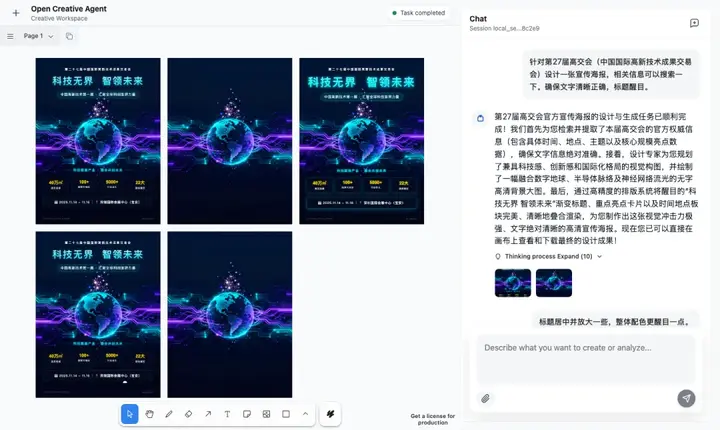
系统最为人看重的特点,是成品上的文字准确无误。文字出错是当前图像生成技术的普遍短板,海报上的标题缺笔少画、时间地点似是而非,作品再美观也难以真正使用——人工智能生成内容长期停留在“参考”而难以“交付”,原因多半在此。Open Creative Agent 的做法是“先核实、后排版、再成图”:需要真实信息的内容,先经联网检索核实;全部文字由排版环节精确置入,而后整体输出为成品图像。如此一来,展会名称、举办时间、活动地点、规模数据都与输入信息严格一致,历经多轮修改也分毫不差。文字站得住,系统才敢以成品的标准交付作品。
而“成品”,正是这套系统交付成果的基本形态。输入一句活动信息,得到的是一张版式完整、可以直接印发的宣传海报;提供一张商品照片,得到的是主图、场景图、细节图齐备的整套电商图组,图中商品与原照片保持一致,不添加、不走样;提出一个选题,得到的是配图已经就位、图文并茂的成稿文章。需要多张图片时,系统一次成组生成;遇到视频这样的复杂形态,系统会先拟出分镜脚本,再逐镜生成、连缀成片。用户无需掌握设计软件,拿到手的作品也无需再行加工。
对话+画布:实时交互,精准修改
创作的过程同样清爽直观。系统界面一半是对话,一半是画布:任务计划与执行进展在对话区实时呈现,生成的作品陆续汇集于画布,可排列、可对比、可下载。成品若有不满意之处,接着说一句就好:“标题居中并放大”“整体配色更醒目”,系统在原有作品上精准落笔,不推倒重来,从容打磨到满意为止。
本地部署,数据安全:自主配置模型,费用透明
此外,系统部署在本地、数据不出门:不依赖云端服务,无需注册账号,素材与成果都留在用户自己的电脑上。对企业和创作者而言,商品图、营销方案、创意构思都是重要的经营资产,本地部署从根本上避免了这些数据被云端平台留存分析、转而服务同行竞争的风险;所用大模型服务由用户自主配置,支持国内外主流模型,费用清楚透明。
目前,系统已在活动海报、电商图组、科普长图、知识卡片、宣传文章、界面设计等多类场景完成验证,成品图像最高支持 4K 分辨率、十种画幅比例。系统代码、说明文档与部署指引已在 GitHub 平台发布(仓库地址:http://github.com/GML-FMGroup/open-creative-agent),欢迎各界试用并提出宝贵意见。
下一步,团队将持续完善系统能力,陆续推出幻灯片生成、深度调研等功能,不断扩大模型兼容范围,以开源开放促进技术共享,让人工智能在创意设计领域发挥更大价值。
END
素 材 丨生成式大模型团队
编 辑 丨 李沛昱 曾小告
责 编 丨 陈贞儒
欢迎投稿、建议:gmlab@gml.ac.cn

 发布时间:2026-07-21
 作者:光明实验室
 浏览:444次