中文
 EN


ACL 2026 | SDE-SQL:面向数据智能体的自驱动数据库探索框架
![]() 发布时间:2026-07-06
![]() 作者:光明实验室
![]() 浏览:370次
主要内容
Text-to-SQL 任务旨在将自然语言问题转换为可执行 SQL,使用户能够直接访问结构化数据库。尽管大语言模型已显著提升该任务性能,现有方法仍主要依赖推理阶段提供的静态、预处理数据库信息,模型缺乏主动查询和探索数据库的能力,难以充分理解真实数据库中的列语义、值分布和条件组合关系。
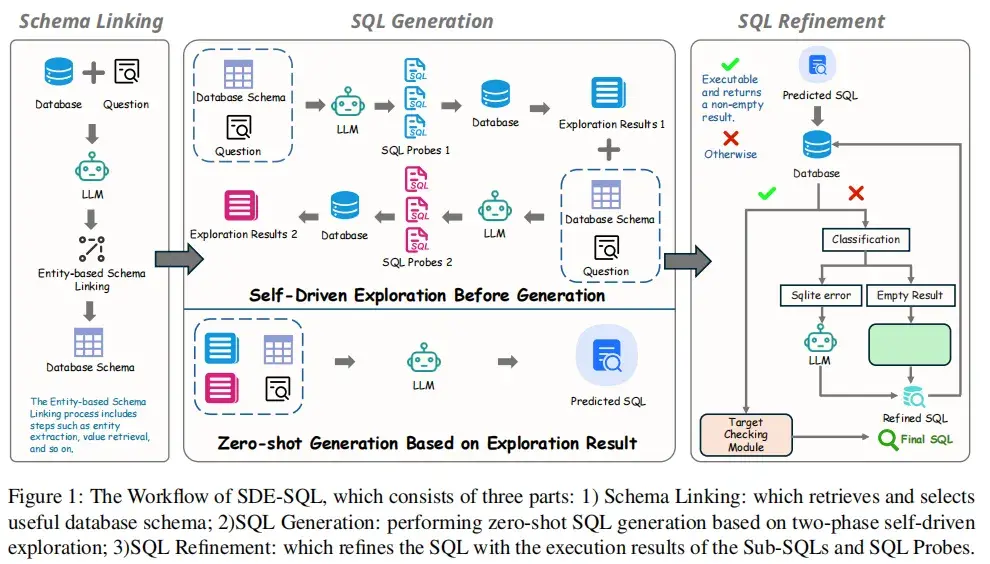
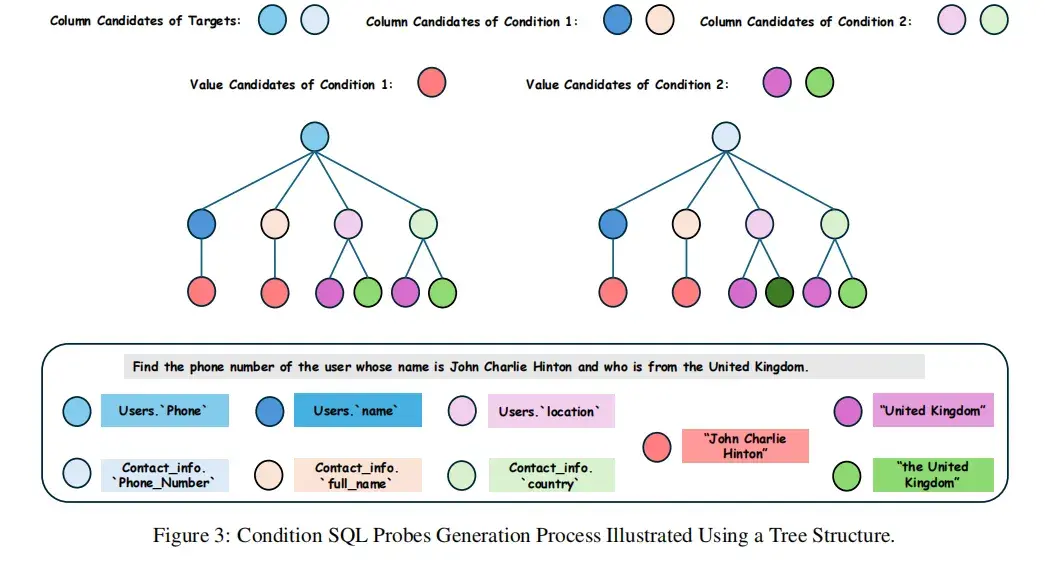
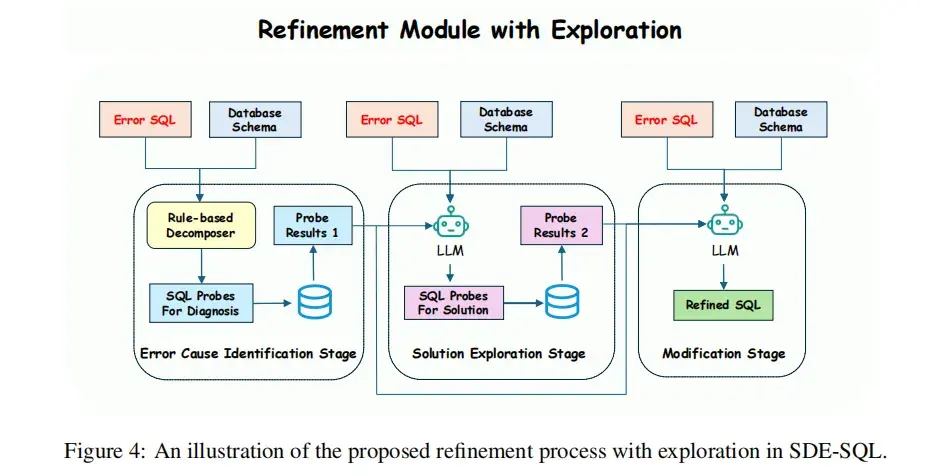
为解决这一问题,作者提出 SDE-SQL 框架,将自驱动探索机制引入 Text-to-SQL:模型在推理过程中自动生成并执行 SQL Probes,主动从数据库中检索信息,并基于执行结果逐步完善对数据库内容的理解。该机制贯穿 SQL 生成与修正两个阶段,在生成前通过探索候选列、候选值和条件组合增强数据库理解,在修正阶段通过 Sub-SQL 与 SQL Probes 诊断空结果等潜在错误并迭代优化查询。SDE-SQL 无需上下文示例或 question-SQL 样例即可在 zero-shot 设置下工作,并可结合监督微调进一步提升性能。
实验结果
实验在 BIRD 和 Spider 两个 Text-to-SQL 基准上进行, 结果显示SDE-SQL 显著提升了开源大模型的 SQL 生成能力。
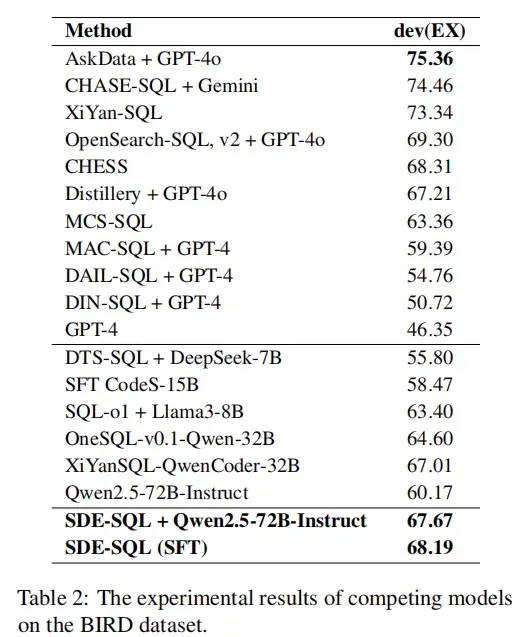
在 BIRD 基准上,基于 Qwen2.5-72B-Instruct 的 SDE-SQL 在 zero-shot 设置下达到 67.67% 执行准确率,相比原始模型 60.17% 明显提升;结合监督微调后进一步达到 68.19%,在无模型集成的开源方法中表现具有竞争力。
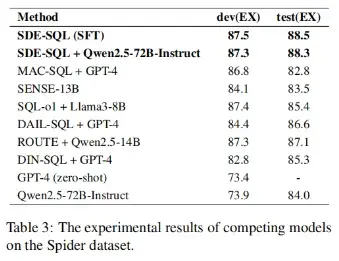
在 Spider 基准上,SDE-SQL 也展现出良好的泛化能力,zero-shot 版本在 dev/test 上分别达到 87.3%/88.3%,SFT 后提升至 87.5%/88.5%,超过多种代表性 GPT-4 方法和开源方法。
消融实验表明,自驱动探索是性能提升的关键。去除生成前探索、修正阶段探索或目标检查模块都会造成下降;同时去除生成与修正阶段的探索后,BIRD 准确率从 67.67% 降至 64.47%。此外,针对 Explorer 和 Generator 的模块级微调可进一步带来 0.52% 的性能增益。
论文还报告了本地 vLLM 部署下的推理延迟:SDE-SQL 在完整 BIRD-dev 上平均每例 35.19 秒,其中生成前探索占主要耗时,整体开销处于可管理范围。
工作贡献
● 提出 SDE-SQL 框架,将 Self-Driven Exploration 引入 Text-to-SQL 推理,使模型能够主动探索数据库来增强推理能力和交互能力,而不是只依赖静态预处理上下文,从而显著缩小其与人类专家之间的差距。
● 设计了贯穿 SQL 生成与修正阶段的统一探索机制,使大语言模型能够主动查询数据库、诊断潜在错误,并迭代提升 SQL 查询质量。
● 在 BIRD 和 Spider 基准上进行了系统实验验证,并通过消融实验验证了 Self-Driven Exploration 对提升 Text-to-SQL 执行准确率的有效性。
● 构建用于探索与生成任务的小规模监督微调数据,证明了有针对性的模块级微调能够进一步提升 SDE-SQL 的性能。
更多内容和细节请阅读论文,欢迎大家跟进和引用:
论文链接:
https://aclanthology.org/2026.acl-long.116.pdf
@inproceedings{xie2026sde,
title={Sde-sql: Enhancing text-to-sql generation in large language models via self-driven exploration with sql probes},
author={Xie, Wenxuan and Dai, Yaxun and Jiang, Wenhao},
booktitle={Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers)},
pages={2507--2525},
year={2026}
}
素 材 丨生成式大模型团队
编 辑 丨 李沛昱 曾小告
责 编 丨 陈贞儒
欢迎投稿、建议:gmlab@gml.ac.cn

 发布时间:2026-07-06
 作者:光明实验室
 浏览:370次