中文
 EN


ECCV 2026 | 图像分割新范式LlamaSeg:像LLM一样自回归生成高精度Mask,200万数据开源
![]() 发布时间:2026-06-24
![]() 作者:光明实验室
![]() 浏览:335次
近日,光明实验室生成式大模型团队论文 “LlamaSeg: Image Segmentation via Autoregressive Mask Generation” (作者:Jiru Deng, Tengjin Weng, Tianyu Yang, Wenhan Luo, Zhiheng Li, Wenhao Jiang)成功被人工智能领域顶级会议 ECCV 2026 正式接收。
该工作面向图像分割任务,提出了一种视觉自回归分割框架 LlamaSeg,将分割掩码表示为离散视觉tokens,并使用 LLaMA 风格的 Transformer 进行 Next-token prediction 模式生成分割掩码,从而把像素级分割自然纳入自回归生成范式。论文进一步构建了大规模开放词汇分割数据集 SA-OVRS,包含约 200万个分割掩码,并配套 5,800 余个开放词汇标签或丰富文本描述。同时提出用于衡量生成式分割轮廓质量的 dAHD 指标。实验表明,LlamaSeg 在多个语义分割、开放词汇分割和指代表达分割基准上优于现有视觉生成式方法,并能够生成边界更精细、轮廓更准确的分割结果。
LlamaSeg: Image Segmentation via Autoregressive Mask Generation
Jiru Deng, Tengjin Weng, Tianyu Yang, Wenhan Luo, Zhiheng Li, Wenhao Jiang
主要内容
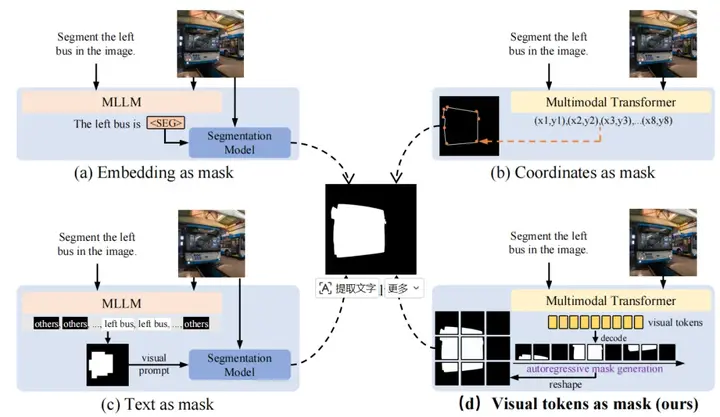
现有多模态大模型和生成式视觉模型虽然能够在多种视觉语言任务上取得进展,但在像素级分割中仍面临统一建模困难、依赖外部分割模块、输出表示不够精细等问题。LlamaSeg 从自回归生成的角度重新建模图像分割,先将 mask 通过 VQGAN 量化为离散视觉 token 序列,再由 Transformer 根据图像和文本提示逐 token 生成目标 mask。如图 1 所示。
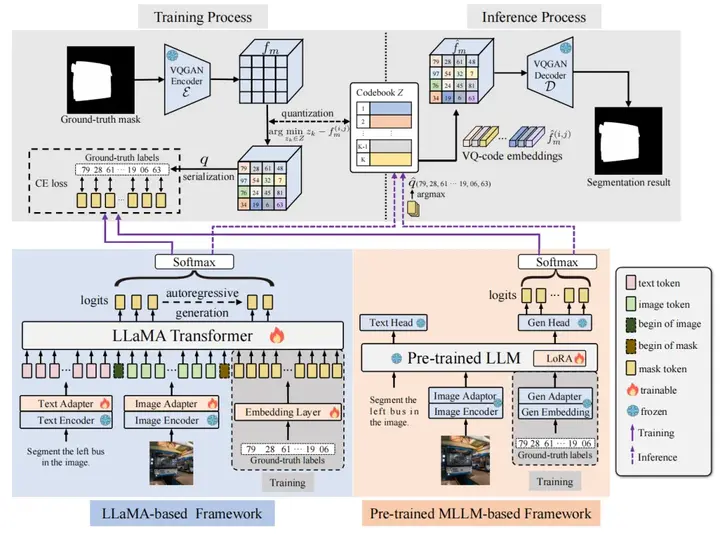
LlamaSeg 由 mask tokenizer 与自回归生成器组成。在训练阶段,真实分割 mask 被量化为离散 code 作为监督信号。在推理阶段,模型根据图像与自然语言提示生成 mask token,并经由 VQGAN decoder 还原为最终分割结果。该框架既支持从头训练,也支持在预训练 MLLM 上通过轻量模块进行适配,如图 2 所示。
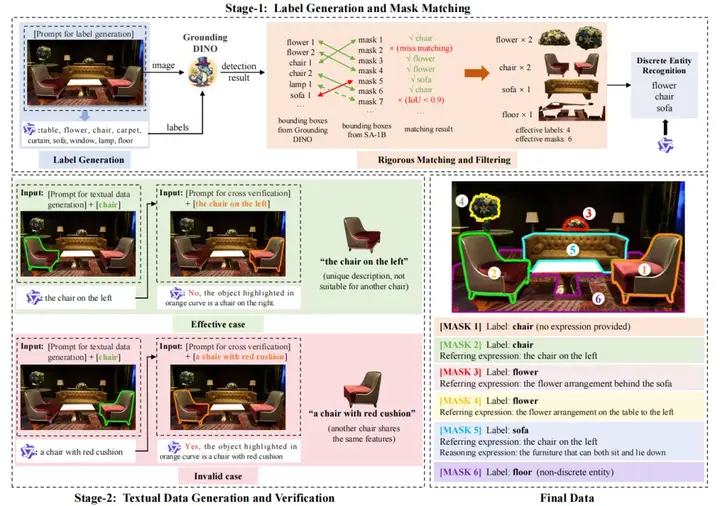
为解决分割训练数据不足的问题,论文设计了两阶段数据标注流程,构建 SA-OVRS 数据集。第一阶段生成开放词汇标签,并通过 GroundingDINO 与 SA-1B masks 进行严格匹配和过滤,第二阶段生成并验证指代表达与推理式描述,使模型能够根据更自然、更开放的文本提示完成分割,如图 3 所示。
核心创新点:
[1] 视觉自回归分割框架:
LlamaSeg 将图像分割从“调用外部分割模块”转化为“生成 mask visual tokens”的自回归任务,使分割能够自然融入 LLM/MLLM 的 Next-token prediction 范式,并直接建模细粒度空间结构。
[2] 大规模开放词汇数据集 SA-OVRS:
论文构建了约 200万个高质量分割 mask,覆盖 5,800+ 开放词汇标签和多样文本描述,其中包含语义样本、指代表达样本和推理式表达样本,为自回归分割模型提供了更充分的数据支撑。
[3] 面向轮廓质量的 dAHD 指标:
针对生成式分割模型常见的边界粗糙问题,论文引入基于多 IoU 阈值的 average Hausdorff Distance 指标,用于更细致地评估预测 mask 与真实 mask 在轮廓层面的贴合程度。
实验结果
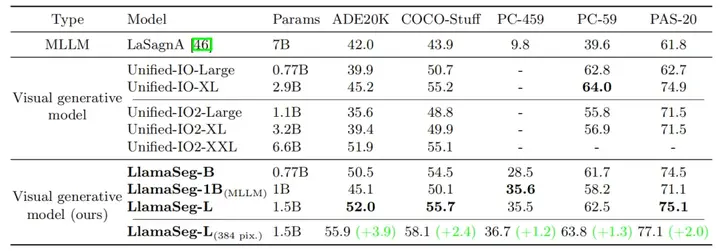
在闭集和开放词汇语义分割任务上,LlamaSeg 在多个基准中超过 Unified-IO、Unified-IO2 等视觉生成式模型。尤其在 384 x 384 像素输入下,LlamaSeg-L 在 ADE20K、COCO-Stuff、PC-459、PC-59 和 PAS-20 上均取得进一步提升,说明更高分辨率的 mask tokens 有助于增强细粒度分割能力。
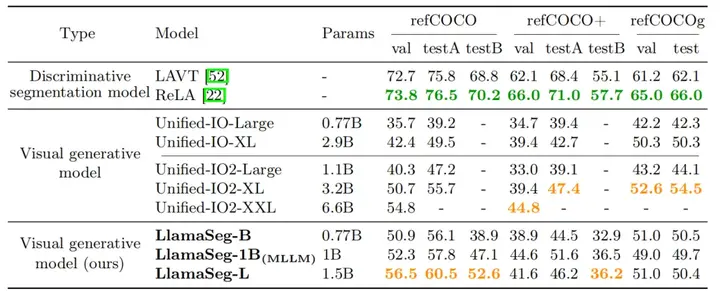
在指代表达分割任务上,LlamaSeg 在同等参数规模下整体优于现有视觉生成式基线。虽然与专门设计的判别式分割模型相比仍存在差距,但 LlamaSeg 的优势在于统一的生成式建模路径:模型可以通过自然语言提示定位目标,并以自回归方式输出分割掩码。
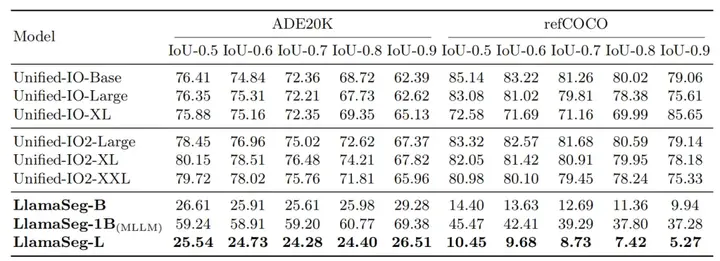
进一步的边界精度评估显示,LlamaSeg 在 mAHD 指标上显著优于 Unified-IO 和 Unified-IO2。以 refCOCO 为例,LlamaSeg-L 在多个 IoU 阈值下均取得更低 mAHD,说明该方法不仅能提升整体分割质量,也能更好地保持目标轮廓和细节边界。
未来计划
LlamaSeg 展示了将图像分割纳入自回归生成范式的可行性,也说明 visual tokens 可以成为连接多模态大模型与密集视觉预测任务的重要表示形式。未来工作可进一步扩展 SA-OVRS 的数据规模、任务类型和场景覆盖范围,增强模型对复杂实例、开放词汇和长文本指令的理解能力。同时,团队也可以继续探索更强的预训练 MLLM 适配策略、更高效的 mask tokenizer 设计以及更稳定的高分辨率生成机制,推动 LlamaSeg 从语义分割、指代表达分割进一步拓展到医学影像、工业质检、自动驾驶感知等真实应用场景。
目前光明实验室生成式大模型团队正在招聘大模型算法研究员、工程师和实习生,欢迎对多模态大模型研究感兴趣的同学加入。有意向者可将简历发送至 jiangwenhao@gml.ac.cn。
论文、代码与数据集资源已同步公开,详情见:
论文页面
https://arxiv.org/abs/2505.19422
代码仓库
https://github.com/GML-FMGroup/llamaseg
数据集页面
https://huggingface.co/datasets/GML-FMGroup/LlamaSeg
END
素 材 丨生成式大模型团队
编 辑 丨 李沛昱 曾小告
责 编 丨 陈贞儒
欢迎投稿、建议:gmlab@gml.ac.cn

 发布时间:2026-06-24
 作者:光明实验室
 浏览:335次